你看到的“深度好文”,有多少是AI的谎言?
你有没有发现,AI其实不懂你。
过去一个多月,DeepSeek爆火,几乎各行各业都在探讨使用它。DeepSeek确实好用,但它有时“一本正经的胡说八道”也确实令人头疼。
比如当我在用AI写分析报告时候,DeepSeek给出的回答常常很有说服力,它会用数据佐证,加上专业名词,一时间让人深以为然,但反复嚼味之后,才发现它把A的概念安装到B上,也会凭空生成一些数据,来合理化结论。这种“胡说八道”、“张冠李戴”的行为,就是“AI幻觉”。
AI幻觉(AI Hallucination)是指大型语言模型在缺乏真实依据的情况下,生成与事实不符但看似合理或可信的内容。其典型表现包括:虚构事件或数据、误引不存在的学术文献、伪造统计结果,最终形成逻辑自洽却本质错误的结论。“AI幻觉”是大模型与生俱来的“基因”问题,是不可消除的。能力越强的模型,“幻觉”越多。
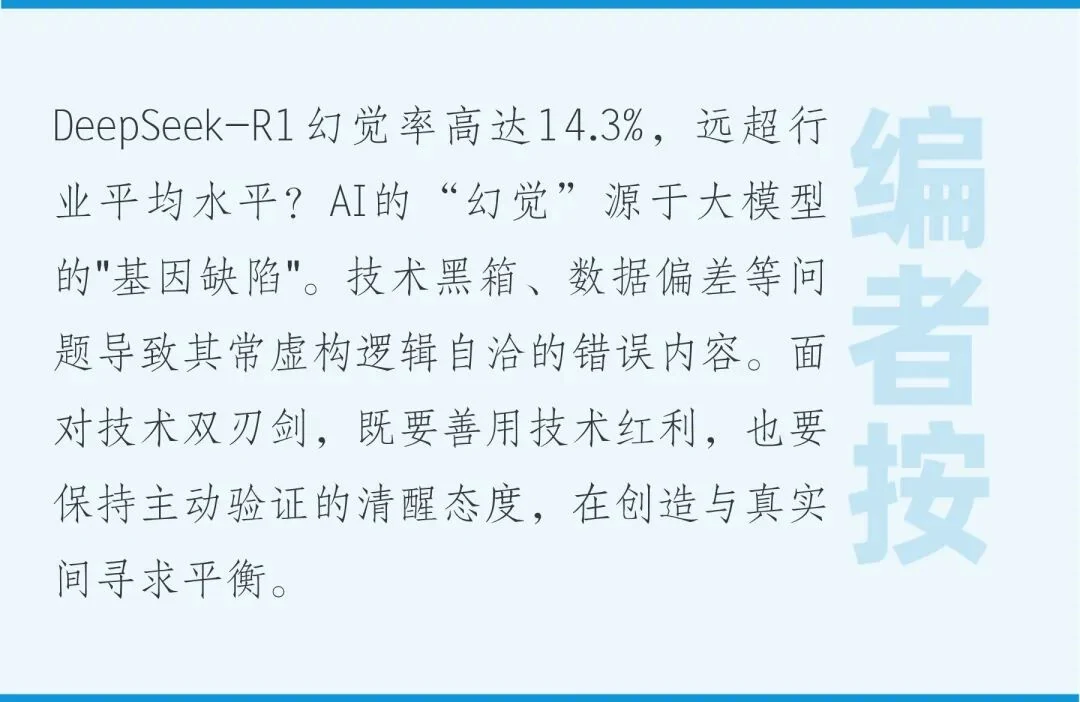
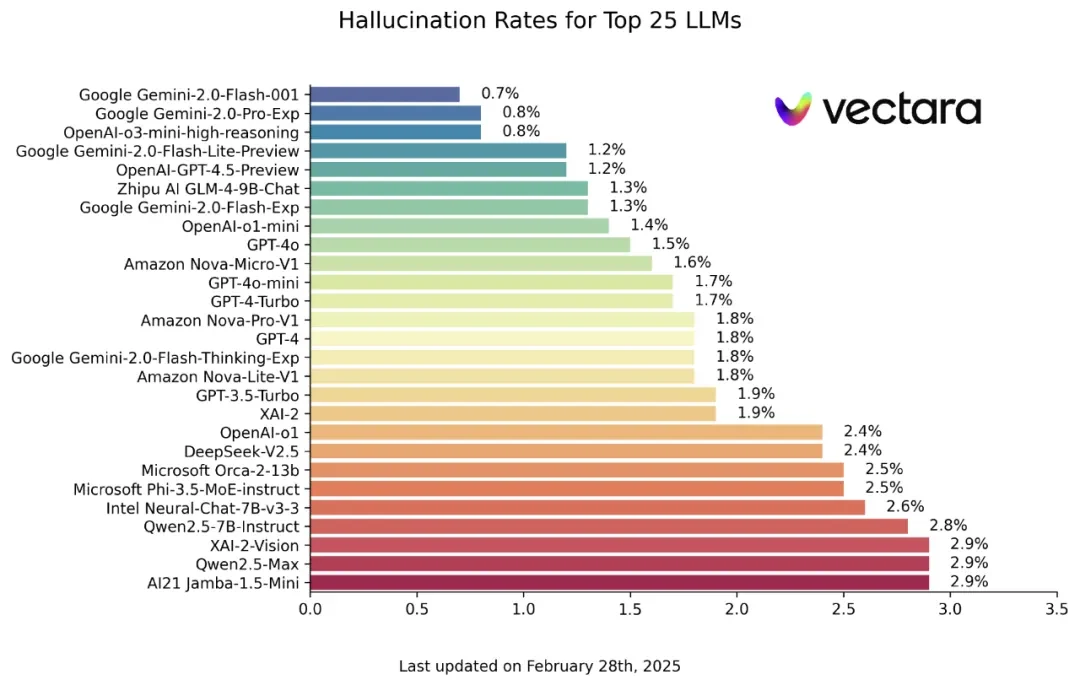
根据Vectara机器学习团队的幻觉测试显示,DeepSeek-R1的幻觉率高达14.3%,这远高于DeepSeek-V3的3.9%,而Google Gemini-2.0-Flash-001、Google Gemini-2.0-Pro-Exp、OpenAI-o3-mini-high-reasoning三款幻觉率都低于1%、GPT-4幻觉率为1.4%、阿里的千问2.5为2-3%之间。
多种因素导致幻觉
"AI幻觉"并非单一因素导致,而是技术、数据、用户等多方面因素共同作用的结果。
从技术层面来说,大模型的训练过程是一个黑箱,内部机制复杂难以解释,这使得模型在生成内容时,其准确性和可靠性不能保证,为“幻觉”的产生埋下隐患。训练数据时,海量语料中既潜藏着隐形的文化偏见与统计噪声,又受到人工标注者主观意识的渗透,难免生成带有认知偏差的结论。
语言包含丰富文化背景、情感色彩等信息,模型本质是概率运算系统,虽能模仿人类语言的流畅性,却难以真正把握语义深度,生成的文本常常"形似神离"。有时大模型为追求对话流畅性进行的优化,往往用虚构内容填补知识空白,形成逻辑自洽却背离事实的幻觉。
用户输入的模糊性也会迫使模型进行意图揣测,而算法为迎合人类偏好形成的"讨好机制",使得社会认知缺陷在数字空间被不断复制强化。这种双向作用揭示:人工智能的幻觉本质是人类认知局限与技术特性共同催生的镜像反映。
三招解决AI“幻觉”
“AI幻觉”是一把双刃剑,是大模型的“基因”问题。但“幻觉”对于实现AGI(通用人工智能)也极其重要,如果大模型没有“幻觉”,就失去了想象力和创造力。
360集团创始人、长江商学院校友周鸿祎说:越是能力强的模型,一般“幻觉”就越多。在科研领域,大模型的“幻觉”能“想象”新药分子结构、蛋白质的结构等,为新研究指引方向。在医疗、法律、金融等对准确性要求高的领域,“幻觉”虽然可能出错,但可以利用技术手段,如RAG(检索增强生成)技术,通过比对专业知识库、网络实时信息等方式予以矫正。
面对“幻觉”,我们有很多方法可以解决,既能保留AI的创造力,又能遏制其“谎言”。
我们可以构建三重防御体系,将AI幻觉风险控制在可控范围内:
第一道防线:结构化提问框架。使用"AI提问约束模型",将提问分解为背景限定、数据范围、输出格式三个维度。这种"问题脚手架"技术,本质上是在数字世界重建物理实验室的受控环境。
第二道防线:多模态交叉验证。建立"三角验证机制",要求AI输出必须通过文本分析、数据可视化、逻辑图谱三种形态自洽。
第三道防线:关键决策双轨制。在医疗诊断等高风险领域,AI初步诊断必须与医生经验判断形成交叉论证。当两者结论差异超过置信区间时,应推送至专家委员会,交由人工复核。
DeepSeek虽然好用,也不能把他当神来看。Marketingforce迈富时创始人&董事长、长江商学院EMBA校友赵旭隆说“要把AI大模型当成一个人,不断的进行训练和调优,慢慢的你会发现它有沉淀,会更懂你,涌现的素材会比你预想的更好。”
我们对待AI的态度应是“利用而不依赖,开放而不放纵”——在享受技术红利的同时,永远对真相保持敬畏。
参考文章:
苏州大学学报哲学社会科学版:《张铮 刘晨旭 | 大模型幻觉:人机传播中的认知风险与共治可能》
中国网:《周鸿祎委员:适度包容大模型“幻觉”,让更多企业大胆创新“复制”DeepSeek的成功》
吴晓波:《DeepSeek炒股,靠不靠谱》
-
眼底照片和糖尿病的关联是?交大安泰团队研发的大模型这样说
넶0 2026-11-14 -
北大光华EMBA重磅升级|四大产业方向之“组织进化”
넶0 2026-11-14 -
科技赋能乡村产业!第五届乡村发展延安论坛在西安举行
넶0 2026-11-14 -
校企合作新模式!复旦大学“康宁创星家”创新管理人才激励计划正式启动
넶0 2026-11-14 -
【沪企行】高金承办“浦江之光”百家中小企业改制上市培育系列培训(第50期)开始报名!
넶0 2026-11-14 -
五道口人丨金融EMBA校友刘振飞:大模型之外,另一条改变世界的AI赛道
넶0 2026-11-14